가중치 수정 없이 에이전트를 진화시키는 법: ReAct 루프와 프롬프트 기억
LLM은 본질적으로 수학적 확률에 따라 다음에 올 단어를 예측하는 ’텍스트 자동완성기’입니다.
그렇다면 질문 하나를 던져보겠습니다.
정적인 텍스트 생성기에 불과한 모델이 어떻게 스스로 터미널 명령을 내리고, 데이터베이스를 조회하며, 오류가 나면 롤백을 수행하는 자율 에이전트(Autonomous Agent)로 동작할 수 있을까요?
더 나아가, 현업에서 에이전트가 엉뚱한 실수를 반복할 때 우리는 정말로 수천만 원을 들여 모델의 가중치(Weights)를 파인튜닝해야만 할까요?
『엔지니어가 이해하는 AI 아키텍처 기본기』 시리즈의 마지막 편에서는 토큰(1편 「AI는 글자가 아니라 토큰을 읽는다: 어휘 사전과 추론의 물리적 실체」)과 MoE 신경망(2편 「MoE는 어떻게 500B 거대 모델을 20B처럼 가볍게 돌리는가?」)을 두뇌로 삼아 외부 환경과 상호작용하는 에이전트 시스템의 동작 메커니즘(ReAct 루프)과, 가중치를 1바이트도 수정하지 않고 시스템 프롬프트 기억(Playbook)만으로 에이전트를 비약적으로 개선한 실전 엔지니어링을 분석합니다.
1. 에이전트의 심장 박동: ReAct (Reason + Act) 루프
에이전트와 단순 챗봇을 가르는 단 하나의 차이는 ReAct (Reasoning + Acting) 루프입니다. 에이전트는 질문에 즉각 답을 내놓지 않습니다. 대신 아래의 3단계 사이클을 반복하며 목적지에 도달합니다.
flowchart TD
    Prompt["사용자 목표 / 컨텍스트"] --> Think

    subgraph ReActLoop ["에이전트 ReAct 실행 루프 (Harness 제어)"]
        Think["1. 생각 (THINK / Reasoning)<br/>현재 상태 분석 및 다음 할 일 계획"]
        --> Act["2. 행동 (ACT / Tool Call)<br/>호출할 도구명과 파라미터를 JSON으로 출력"]
        --> Execute["하네스가 실제 도구 실행<br/>(API 호출, SQL 쿼리, Bash 실행)"]
        --> Observe["3. 관찰 (OBSERVE / Observation)<br/>도구의 실행 결과/에러 메시지를 수신"]
        --> Check{"목표 완수 여부 판정"}
    end

    Check -- "미완료 / 추가 작업 필요" --> Think
    Check -- "완료" --> FinalOutput["최종 응답 보고"]
동작 메커니즘
- 생각 (THINK): 모델은 “환불을 처리하려면 먼저 주문 상태와 결제 수단을 확인해야 한다”고 내부 추론을 전개합니다.
- 행동 (ACT): 모델이 텍스트로
call: lookup_order(order_id="1024")라는 구조화된 도구 호출 토큰을 출력합니다. - 관찰 (OBSERVE): 에이전트를 감싸고 있는 실행 하네스(Harness)가 이 명령을 가로채 실제 데이터베이스를 조회한 뒤,
status: DELIVERED, payment: CARD라는 결과를 프롬프트 끝에 덧붙여(Append) 모델에게 다시 넘겨줍니다.
모델은 자신이 방금 받은 실행 결과(Observation)를 보고 다음 행동(Think ➔ Act)을 결정합니다.
즉, 에이전트란 신비로운 자아를 가진 존재가 아니라, “텍스트 생성 ➔ 도구 실행 ➔ 결과 덧붙이기”를 반복하도록 시스템 하네스(Harness)가 통제하는 제어 루프에 불과합니다.
2. 가장 흔한 착각: “에이전트가 멍청하면 파인튜닝해야 한다?”
현업에서 에이전트를 실무에 투입하면 수많은 실패를 겪습니다.
- 인증 절차를 건너뛰고 결제를 취소하려다 실패함
- 없는 테이블 이름을 조회하며 무한 루프에 빠짐
- 회사의 비즈니스 정책(예: “배송 완료 후 7일 이내만 교환 가능”)을 위반함
이때 많은 팀이 범하는 가장 전형적인 실수는 “에이전트 도메인 적응을 위해 모델 가중치를 파인튜닝(SFT/LoRA)하자“고 나서는 것입니다.
하지만 엔지니어링 관점에서 모델 가중치를 건드리는 것은 가성비가 매우 떨어집니다:
- 파괴적 망각 (Catastrophic Forgetting): 새로운 정책을 외우려다 일반 추론 및 코딩 능력이 망가집니다.
- 배포 및 인프라 파편화: 정책이 바뀔 때마다 체크포인트를 다시 굽고, GPU 서빙 클러스터를 재배포해야 합니다.
- 디버깅 불가능성: 블랙박스 뉴런 속으로 들어간 정책은 “왜 그 순간 그 행동을 했는지” 추적하거나 강제하기 어렵습니다.
3. IBM ALTK-Evolve의 증명: 프롬프트 기억(Playbook)의 승리
최근 IBM Research 연구진이 공개한 ALTK-Evolve 연구는 이 편견을 완전히 깨뜨렸습니다.
연구진은 Sierra가 주최한 엄격한 고객 서비스 에이전트 벤치마크인 τ²-bench에 도전했습니다.
이 벤치마크는 말만 잘한다고 통과되지 않습니다. 에이전트가 도구를 호출해 백엔드 데이터베이스의 최종 상태(Terminal Database State)를 정확히 수정했는가를 1과 0의 엄격한 이진 보상으로 판정합니다. 4번의 독립된 시도에서 모두 성공해야 1건으로 인정(Pass^4)됩니다.
[실험 조건]
- 모델: 프론티어 추론 모델(o1 등)이 아닌 일반 비추론 모델 'GPT-4.1'
- 스캐폴드: 표준 순정 ReAct 프레임워크 그대로 사용
- 가중치 훈련: 0% (Zero Weight Update, 파인튜닝 일절 없음)
- 인간 라벨러 개입: 0명
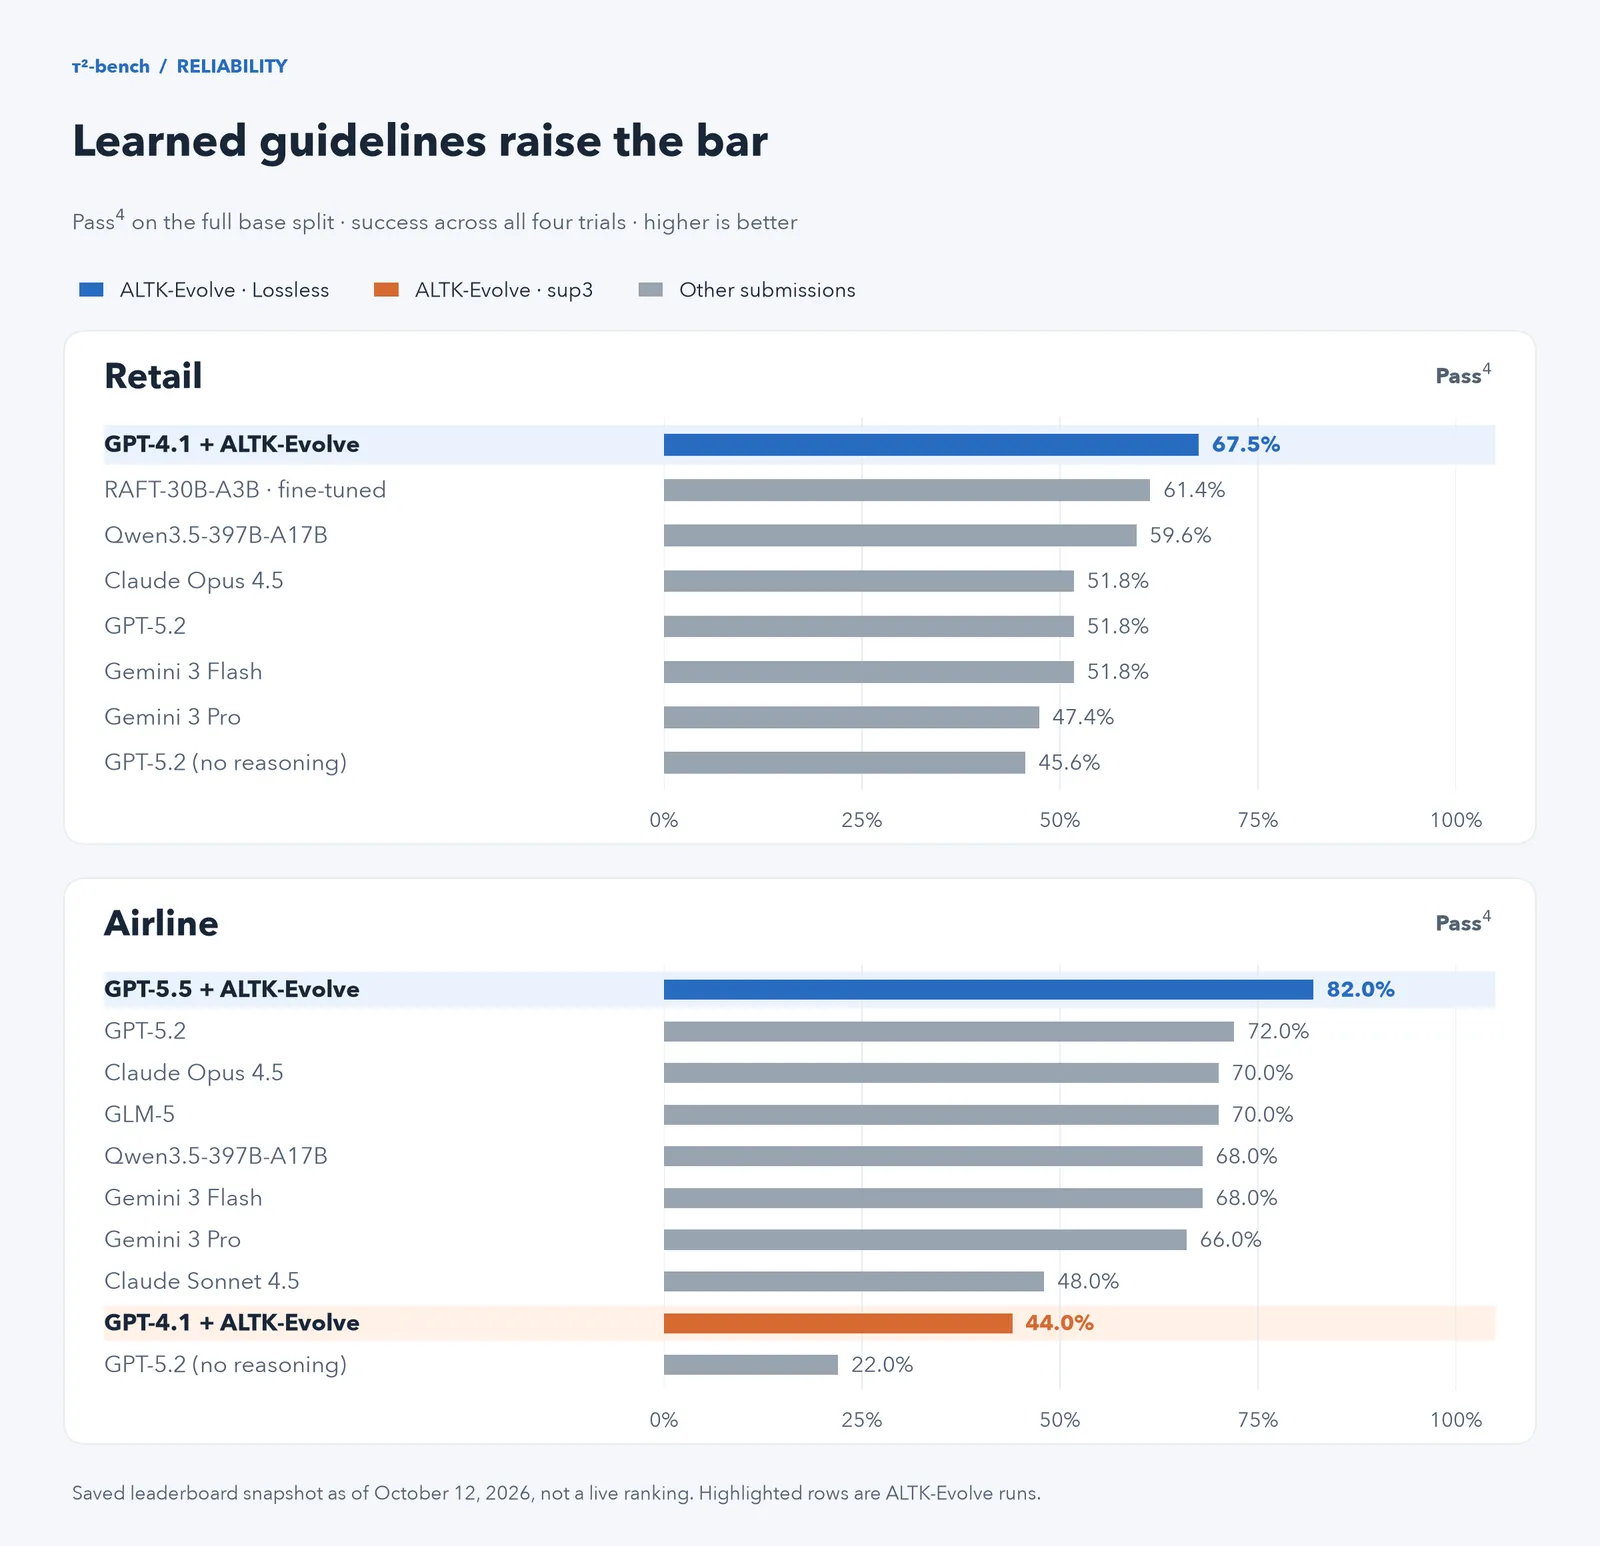
결과는 놀라웠습니다. GPT-4.1 기반의 기본 ReAct 에이전트가 벤치마크 리테일 부문에서 67.5% Pass^4를 기록하며 기라성 같은 상용 모델들을 제치고 1위를 차지했습니다.
flowchart LR
    Attempts["에이전트의 이전 시도들 <br/> (성공과 실패 로그)"]
    -->|모델 스스로 실패 원인 분석| Distill["규칙 증류 (Distillation) <br/> '환불 전 고객 인증을 필수 실행할 것'"]
    -->|시스템 프롬프트 뒤에 마크다운 추가| Playbook["In-Context Playbook <br/> <guidelines> ... </guidelines>"]
    -->|다음 실행 시 참조| SOTA["가중치 수정 없이 벤치마크 1위 달성"]
어떻게 가능했을까?
비결은 ’학습된 기억(Learned Memory / Playbook)’에 있었습니다.
- 실패와 성공의 자동 분석: 에이전트가 과거 연습 과제에서 겪은 수많은 도구 호출 로그를 모델 스스로 분석하게 했습니다.
- 행동 지침(Playbook) 증류: 모델은 실패 사례에서 핵심 규칙을 1~2줄의 명확한 문장으로 뽑아냈습니다.
- “반품 요청을 처리하기 전에 반드시
authenticate_customer도구로 본인 확인을 먼저 거칠 것.” - “운송장 번호가 누락되었을 때는 임의 값을 넣지 말고
list_orders로 최근 주문을 재조회할 것.”
- “반품 요청을 처리하기 전에 반드시
- 프롬프트 인젝션: 추출된 지침들을 모델의 시스템 프롬프트
<guidelines>섹션 뒤에 일반 마크다운 목록으로 덧붙였을 뿐입니다.
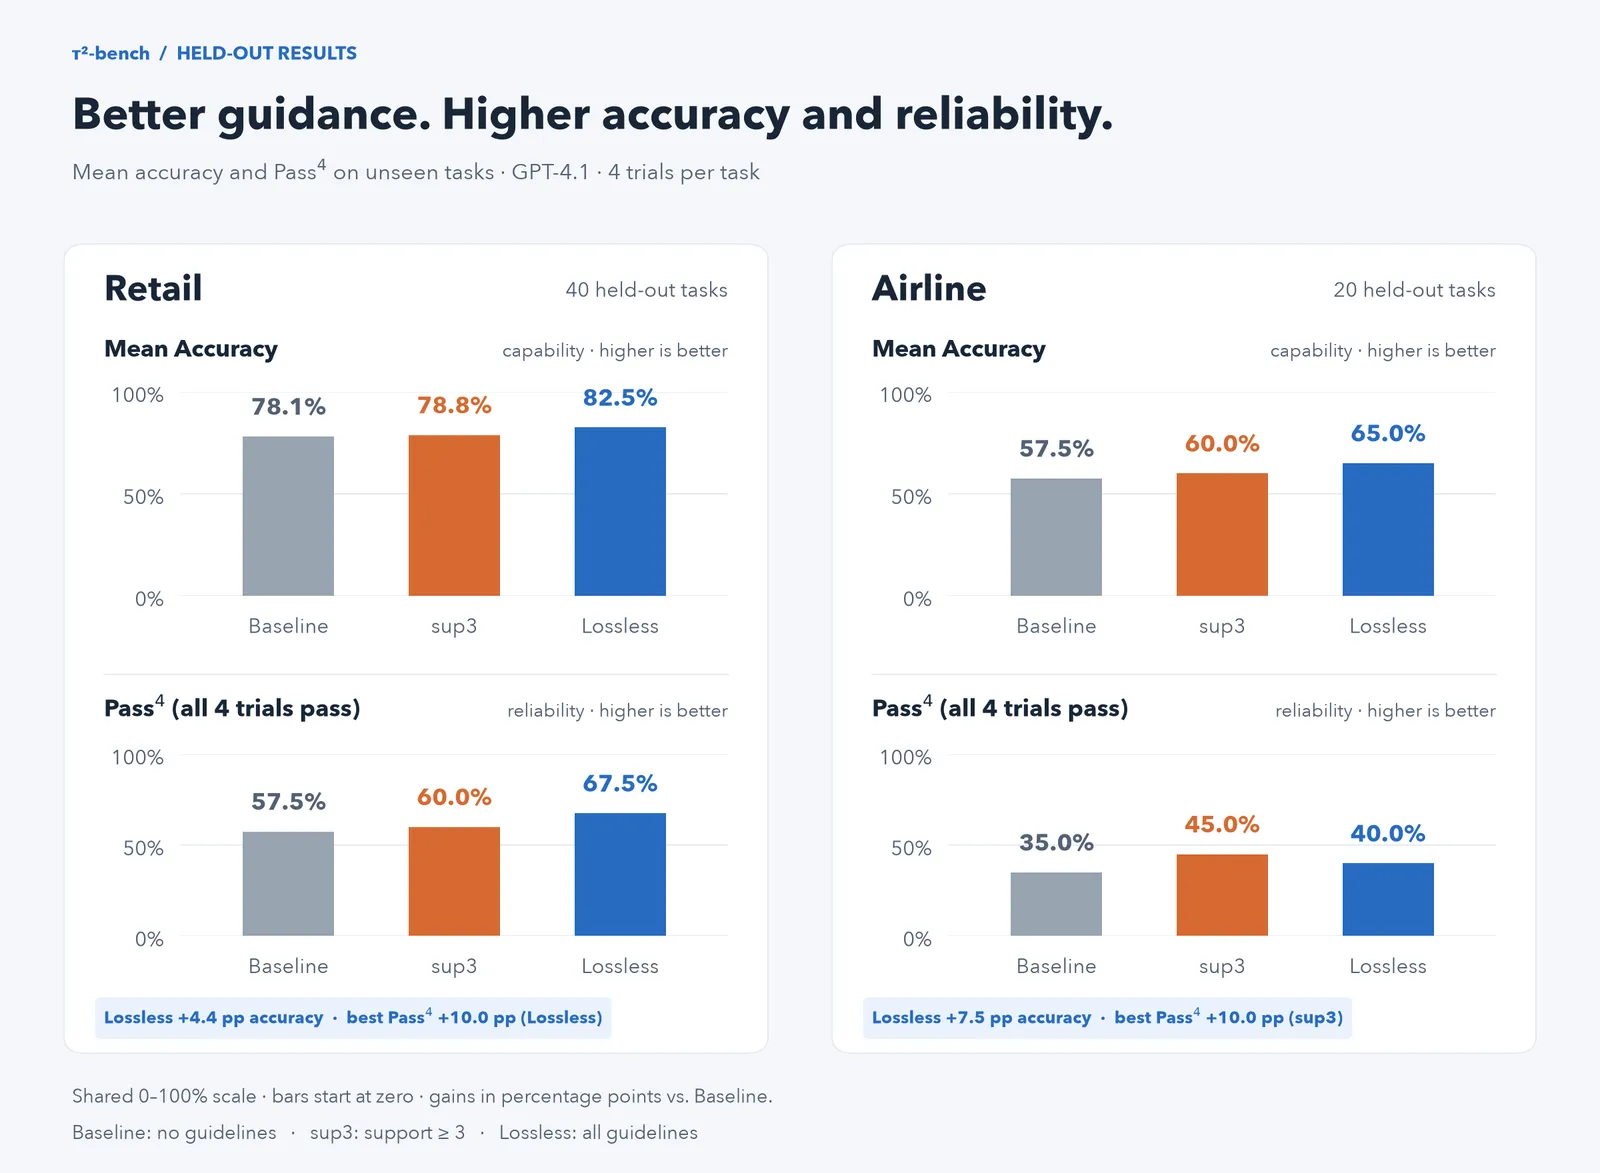
모델의 뉴런 가중치를 건드린 것은 단 1비트도 없었습니다. 하지만 프롬프트에 추가된 몇 줄의 룰북이 에이전트의 경로 이탈(Drift)을 완벽하게 틀어쥐었습니다.
4. 인프라 엔지니어가 바라본 에이전트 메모리 설계
이 결과는 에이전트 아키텍처를 설계하는 엔지니어에게 매우 중요한 교훈을 줍니다.
| 구분 | 가중치 메모리 (Parametric Memory) | 컨텍스트 메모리 (In-Context Memory / Playbook) |
|---|---|---|
| 저장 위치 | 모델 내부의 신경망 가중치 (Weights) | 시스템 프롬프트 및 컨텍스트 윈도우 |
| 갱신 방식 | GPU 재학습(Fine-Tuning) 필요 | 텍스트 파일(마크다운/YAML) 즉시 수정 |
| 반영 속도 | 며칠~수주일 소요 | 0초 (배포 즉시 반영) |
| 롤백/감사 | 체크포인트 롤백 필요, 원인 분석 난망 | git diff로 변경 이력 완벽 추적 가능 |
| 통제력 | 비결정론적 확률에 의존 | 규칙 위반 시 즉각 강제(Rule Enforcement) 가능 |
인프라 엔지니어에게 이것은 익숙한 개념입니다.
우리는 리눅스 커널의 C 소스코드를 매번 다시 컴파일(가중치 수정)하지 않습니다. 대신 /etc/ 디렉토리 아래의 설정 파일(Configuration File)을 수정하여 커널의 동작을 제어합니다.
에이전트 시스템도 마찬가지입니다.
기본 추론 능력은 잘 만들어진 베이스 모델에 맡기고, 도메인 규칙과 실패 방지 대책은 컨텍스트 윈도우라는 런타임 메모리(Playbook)로 통제하는 것이 훨씬 유지보수하기 쉽고, 안전하며, 비용 효율적인 아키텍처입니다.
🏁 3부작을 마치며: 시스템 엔지니어링으로 본 AI 기본기
3편에 걸친 기본기 탐색을 통해 우리는 에이전트 시스템의 밑바닥부터 최상위 계층까지를 모두 관통했습니다.
- 1편 (추론과 토큰): LLM의 물리적 병목은 디코드 단계의 메모리 대역폭에 있으며, 출력 토큰과 어휘 사전을 압축하는 것이 인프라의 핵심입니다.
- 2편 (MoE 아키텍처): 거대한 지식을 품으면서도 필요한 전문가만 깨워 연산 비용을 10분의 1로 압축하는 전문가 라우팅의 원리를 확인했습니다.
- 3편 (ReAct와 기억): 텍스트 생성기가 ReAct 제어 루프를 통해 비로소 프로그램이 되며, 가중치가 아닌 컨텍스트 룰북으로 에이전트를 안전하게 길들일 수 있음을 배웠습니다.
결국 성공적인 AI 에이전트 시스템을 만드는 힘은 화려한 프롬프트 기술에 있지 않습니다.
하드웨어의 물리적 한계를 이해하고, 적절한 모델 구조를 라우팅하며, 견고한 실행 하네스(Harness)로 통제하는 정통 시스템 엔지니어링의 기본기에 있습니다.