MoE는 어떻게 500B 거대 모델을 20B처럼 가볍게 돌리는가?
최근 오픈소스 및 프론티어 AI 모델의 스펙표를 보면 당혹스러운 숫자 조합이 자주 등장합니다.
“총 파라미터 501B (5,010억 개), 토큰당 활성 파라미터 23B (230억 개).”
“총 파라미터 40B, 활성 파라미터 2.5B.”
파라미터가 5,000억 개라면 FP16 기준으로 모델 가중치만 1TB(테라바이트)에 달하는 거대한 괴물입니다. 그런데 어떻게 이런 모델을 20B~30B 수준의 중소형 모델 연산량과 속도로 구동할 수 있을까요?
비결은 현대 파운데이션 모델의 사실상 표준 아키텍처로 자리 잡은 MoE(Mixture of Experts, 전문가 혼합)에 있습니다.
지난 1편 「AI는 글자가 아니라 토큰을 읽는다: 어휘 사전과 추론의 물리적 실체」에서는 토큰과 어휘 사전, 그리고 디코드(Decode) 단계의 메모리 대역폭 병목을 다루었습니다. 이번 2편에서는 한 계단 올라가, 파운데이션 모델이 파라미터의 폭발적인 증가를 감당하면서도 연산 비용을 통제하기 위해 신경망 내부를 어떻게 분할했는지 그 기본기를 살펴봅니다.
1. 밀집(Dense) 모델의 한계: 모든 의사가 모든 환자를 본다
GPT-3 시절까지 사용되던 전통적인 신경망을 밀집(Dense) 모델이라고 부릅니다. 밀집 모델의 동작 방식은 단순무식합니다. 입력된 단어 하나(토큰)를 계산하기 위해 모델 안에 존재하는 수천억 개의 모든 가중치(Weights)와 뉴런이 동시에 깨어나 행렬 곱셈을 수행합니다.
flowchart LR
    Token["입력 토큰 <br/> ('SELECT * FROM users')"]
    --> AllWeights["밀집(Dense) 신경망 <br/> 5,000억 개 파라미터 전체 가동"]
    --> Output["다음 토큰 예측"]
이 방식은 종합병원에 비유할 수 있습니다.
환자가 감기에 걸려 내과를 찾아왔는데, 내과 의사뿐 아니라 정형외과, 신경외과, 소아과, 피부과 의사까지 수십 명이 우르르 몰려나와 환자 한 명을 동시에 진료하는 꼴입니다.
상식적으로 비효율적입니다.
- 모델의 지능(용량)을 높이려면 파라미터를 늘려야 합니다.
- 하지만 파라미터를 늘리는 족족 매 토큰마다 요구되는 연산량(FLOPs)과 전력 소모, 발열이 정비례하여 폭증합니다.
- 1편에서 보았듯 디코드 단계에서 매 스텝마다 테라바이트급 가중치를 메모리에서 긁어와야 하므로 추론 지연 시간(Latency)이 감당할 수 없을 만큼 느려집니다.
2. MoE의 기본 원리: 지식의 용량과 연산의 분리
MoE는 이 모순을 깨기 위해 탄생했습니다. 핵심 아이디어는 명쾌합니다: “지식은 넓게 보관하되, 계산은 필요한 전문가만 시킨다.”
MoE 모델은 피드포워드 신경망(FFN) 레이어를 수십~수백 개의 독립된 작은 전문 서브 네트워크(전문가, Experts)로 쪼갭니다. 그리고 그 앞단에 어떤 전문가를 호출할지 결정하는 라우터(Router) 신경망을 배치합니다.
flowchart TD
    Token["입력 토큰"] --> Router["라우터 (Router / Gating Network)"]

    subgraph Experts ["256개의 전문가 풀 (총 501B 용량)"]
        E1["Expert 1 (파이썬)"]
        E2["Expert 2 (SQL)"]
        E3["Expert 3 (의료/생물)"]
        E4["Expert 4 (수학/추론)"]
        E256["Expert 256 (...)"]
    end

    Router -->|상위 8개만 활성화 (Top-k Routing)| E1 & E4
    Router -.->|비활성화 (연산 스킵)| E2 & E3 & E256

    E1 & E4 --> Aggregator["결과 가중합 (Weighted Sum)"] --> Out["출력 토큰"]
501B 오픈 모델 ’Beam 1.0’의 실제 사례
최근 오픈 가중치로 공개된 초대형 MoE 모델인 Beam 1.0의 내부 구조를 보면 이 원리가 수치로 생생하게 드러납니다.
| 스펙 항목 | 실제 수치 | 엔지니어링 의미 |
|---|---|---|
| 전체 파라미터 (Total) | 501B (5,010억 개) | 인간의 언어, 코딩, 수학 등 방대한 지식을 담는 총 서가 용량 |
| MoE 레이어당 전문가 수 | 256개 | 문제를 세부 영역별로 극도로 잘게 분업화 |
| 토큰당 선택 전문가 (Top-k) | 8개 | 256개 중 문맥에 가장 적합한 상위 8개 전문가만 가동 |
| 활성 파라미터 (Active) | 단 23B (230억 개) | 실제 토큰 생성 연산에 쓰이는 파라미터는 전체의 4.6%에 불과 |
| 컨텍스트 윈도우 | 1,000,000 토큰 (1M) | 대규모 코드베이스를 한 번에 올리는 장기 기억 |
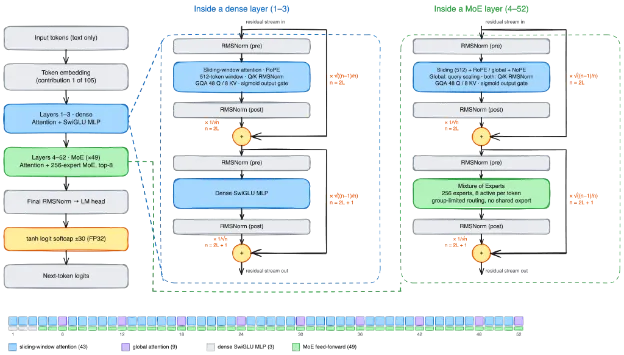
501B라는 거대한 지식의 숲을 가지고 있으면서도, 토큰을 뱉어낼 때 실제로 GPU 연산 코어를 태우는 것은 단 23B짜리 중형 모델 수준입니다. 감기 환자가 오면 라우터가 내과 의사 8명만 호출해 빠르게 진료를 끝내고 환자를 내보내는 것과 같습니다.
3. 라우터(Router) 신경망은 어떻게 전문가를 고르는가?
MoE 아키텍처의 성패는 라우터(Router / Gating Network)에 달려 있습니다. 라우터는 입력 토큰의 임베딩 벡터를 입력받아, 256개 전문가 각각에 대한 적합도 점수(Logits)를 계산합니다.
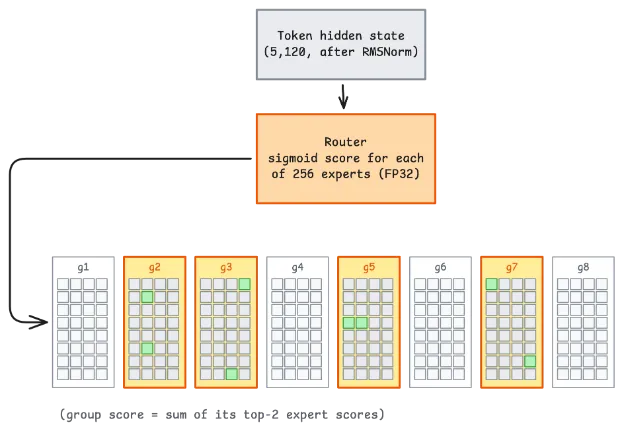
- 소프트맥스 확률 계산: 각 전문가가 이 토큰을 처리하기에 얼마나 적합한지 0과 1 사이의 확률을 매깁니다.
- Top-k 선택: 확률이 가장 높은 상위 $k$개(Beam의 경우 8개)의 전문가만 활성화합니다.
- 가중합(Weighted Sum): 선택된 8개 전문가의 연산 결과에 라우터가 매긴 확률 가중치를 곱해 하나로 합칩니다.
라우터 엔지니어링의 난제: 전문가 편중 (Expert Collapse)
MoE를 훈련할 때 가장 흔히 겪는 장애는 전문가 편중(Expert Collapse) 현상입니다.
라우터가 초기에 성능이 조금 더 좋았던 특정 2~3개의 전문가에게만 모든 토큰을 몰아주는 현상입니다. 이렇게 되면 그 전문가들만 과부하가 걸려 GPU VRAM과 연산 병목이 발생하고, 나머지 수백 개의 전문가는 놀고먹는 유령 뉴런이 되어버립니다.
그래서 현대 MoE 아키텍처는 손실 함수(Loss)에 부하 분산 보조 손실(Auxiliary Load Balancing Loss)을 강제합니다. 모든 전문가가 골고루 토큰을 나누어 처리하도록 라우터에게 일종의 ’교통정리 페널티’를 부여하는 것입니다.
4. 인프라 엔지니어가 바라본 MoE의 현실: 기회와 트레이드오프
MoE가 기적처럼 보이지만, 인프라를 직접 구축하고 운영하는 엔지니어 입장에서는 명확한 물리적 한계와 트레이드오프를 이해해야 합니다.
[MoE의 인프라 등가 교환]
얻는 것: 연산량(FLOPs) 대폭 감소, 지연 시간(Latency) 단축, 높은 토큰 처리량(Throughput)
치르는 대가: 모델 가중치 저장을 위한 막대한 VRAM 메모리 용량 요구- 연산량은 23B지만, 메모리(VRAM)는 500B가 필요합니다.
토큰당 23B만 계산한다고 해서 23B 분량의 GPU 메모리만 있으면 되는 것이 아닙니다. 언제 어떤 전문가가 호출될지 모르기 때문에 256개 전문가 전체(501B 가중치)가 반드시 GPU VRAM에 상주해 있어야 합니다. - 해법: 양자화(Quantization)와의 결합
이 메모리 장벽을 깨기 위해 최신 MoE 모델들은 FP8이나 차세대 NVFP4 같은 초저정밀도 양자화 포맷을 필수적으로 채택합니다. Beam 1.0이 FP8과 NVFP4 체크포인트를 공식 배포하는 이유도, 501B의 메모리 발자국(Footprint)을 압축하여 소규모 GPU 노드에서도 올릴 수 있도록 만들기 위함입니다. - 배치 크기(Batch Size)와 전문가 분산
동시 요청(Batch)이 수천 개로 늘어나면, 256개 전문가가 고르게 호출되면서 GPU 코어가 쉬지 않고 풀가동됩니다. 대규모 엔터프라이즈 서빙 환경에서 MoE가 Dense 모델 대비 압도적인 가성비를 뽑아내는 이유입니다.
5. 요약: 파운데이션 모델의 숲을 보는 눈
우리는 흔히 모델의 성능을 비교할 때 단순히 “몇 B짜리 모델인가”라는 숫자 하나로 평가하곤 합니다.
하지만 현대 AI 아키텍처에서 그 숫자는 더 이상 연산 비용을 대변하지 않습니다.
- 밀집(Dense) 모델: 정직하지만 무식합니다. 파라미터가 늘어날수록 연산 비용이 감당 불가능해집니다.
- 전문가 혼합(MoE) 모델: 영리한 분업입니다. 거대한 지식의 창고(Capacity)를 보유하되, 런타임에는 필요한 전문가만 번개처럼 깨워 연산 비용(Compute)을 10분의 1로 압축합니다.
다음 편에서는 이렇게 고효율로 설계된 파운데이션 모델을 두뇌로 삼아, 어떻게 외부 도구를 호출하고 스스로 실수를 바로잡는 ’자율 에이전트 시스템(ReAct & Memory)’을 구축하는지 살펴봅니다.
다음 편 예고
[AI 아키텍처 기본기 3편]
“가중치 수정 없이 에이전트를 진화시키는 법: ReAct 루프와 프롬프트 기억”
IBM ALTK-Evolve 사례를 통해 단순 텍스트 생성기가 스스로 도구를 쓰고 실수를 교정하는 에이전트 시스템 메커니즘을 살펴봅니다.