AI는 글자가 아니라 토큰을 읽는다: 어휘 사전과 추론의 물리적 실체
대다수의 개발자는 LLM API를 호출할 때 화면에 찍히는 글자 수나 청구서의 토큰 수만 보게 됩니다.
“입력 1,000 토큰, 출력 1,000 토큰.”
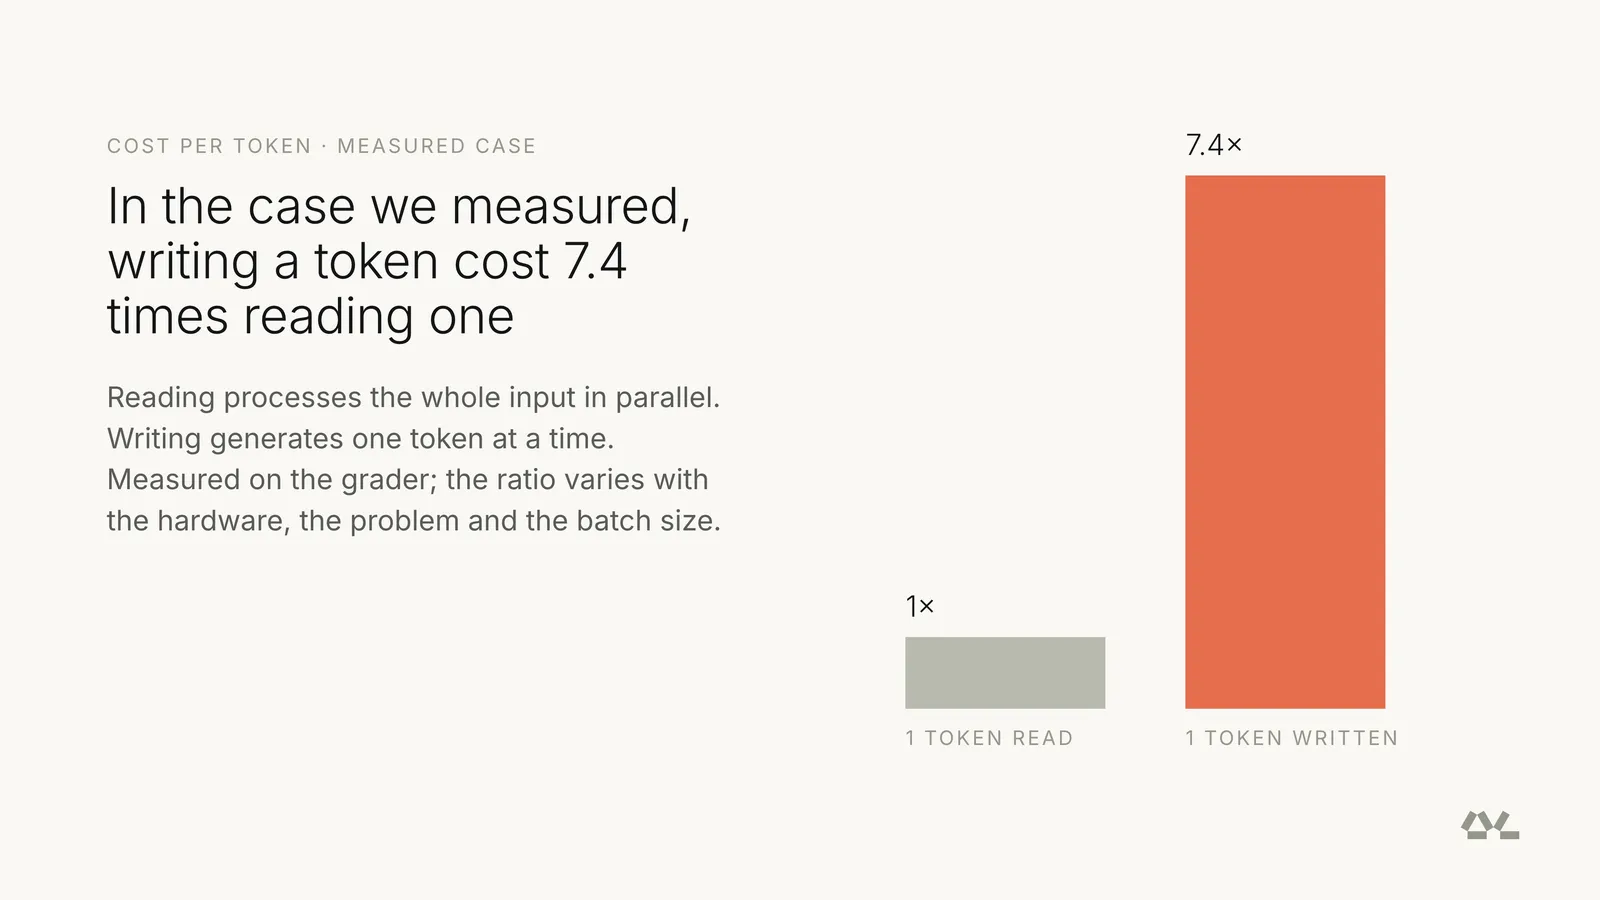
숫자만 보면 둘은 대등해 보입니다. 하지만 모델을 실제로 서빙하는 GPU 인프라 관점에서 보면, 입력 1,000 토큰을 읽는 작업과 출력 1,000 토큰을 생성하는 작업은 물리적으로 완전히 다른 성격의 연산입니다. 실제로 운영 환경에서 생성 토큰 1개는 입력 토큰 1개보다 최소 7배 이상 비싸고 느립니다.
왜 이런 차이가 발생할까요? 이번 글에서는 LLM의 가장 밑바닥 기본기인 토큰(Token), 어휘 사전(Vocabulary), 그리고 추론(Inference)의 두 단계인 프리필(Prefill)과 디코드(Decode)를 하드웨어 동작 관점에서 차근차근 짚어봅니다.
1. LLM은 글자를 읽지 않는다: 어휘 사전(Vocabulary)의 함정
LLM은 텍스트를 글자(Character) 그대로 처리할 수 없습니다. 모든 문장은 수학적 계산을 위해 토크나이저(Tokenizer)를 거쳐 숫자 ID의 배열인 토큰(Token)으로 쪼개집니다.
그리고 모델은 태어날 때부터 자기가 이해할 수 있는 단어 목록인 어휘 사전(Vocabulary)을 고정된 크기로 들고 태어납니다.
flowchart LR
    Text["원문 텍스트 <br/> '{\"status\": \"approved\"}'"]
    -->|토크나이저 BPE 분할| Tokens["토큰 ID 시퀀스 <br/> [102, 5421, 15, 8821, 103]"]
    -->|어휘 사전 매핑| Model["LLM 임베딩 & 연산"]
Qwen, Llama, Gemma 같은 최신 오픈 파운데이션 모델들은 전 세계 수십 개 언어, 프로그래밍 소스 코드, 수학 기호, 마크다운 문법까지 전부 소화해야 합니다. 그래서 이들의 어휘 사전은 보통 150,000개에서 250,000개에 달할 정도로 거대합니다.
범용 인공지능으로서는 훌륭한 선택입니다. 하지만 이 모델을 가져와 특정 단일 업무(예: 한국어 계약서 검토, 영수증 JSON 파싱, 사내 API 분류)에 투입하는 순간, 이 거대한 어휘 사전은 인프라에 두 가지 낭비를 일으킵니다.
① 파편화 (Fragmentation)
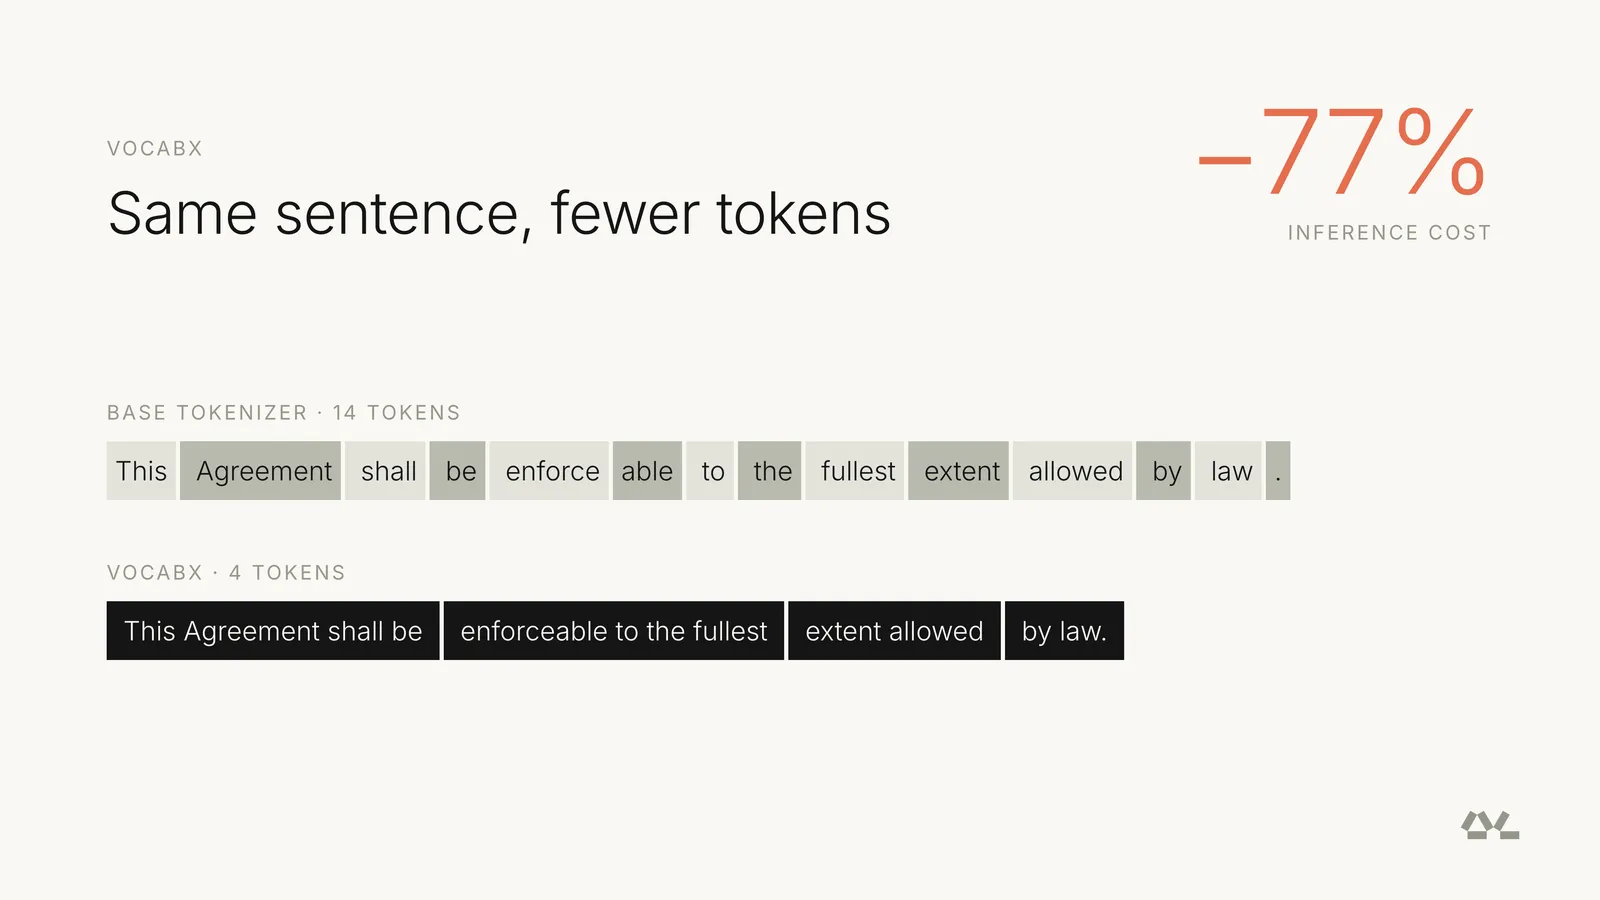
도메인에서 가장 빈번하게 반복되는 단어가 여러 개로 잘게 쪼개집니다.
예를 들어 JSON 응답을 매번 출력하는 에이전트가 있다고 해보겠습니다. 모델은 매 요청마다 {"status": "success", "result": ...}를 출력해야 합니다.
하지만 다국어 범용 어휘 사전에는 이런 특정 JSON 키 조합이 통째로 등록되어 있지 않습니다. 결국 {", status, ":, ", success, "} 처럼 6~7개 이상의 토큰으로 잘게 쪼개져 출력됩니다. 1개 토큰으로 족할 텍스트에 7배의 토큰 비용을 매 요청마다 지불하는 셈입니다.
② 과잉 (Excess)
어휘 사전에는 해당 업무에서 평생 쓸 일 없는 수만 개의 단어가 들어 있습니다. 한국어 의료 기록을 분석하는 모델이 아랍어 토큰, 키릴 문자, 희귀 고유명사를 쓸 일은 거의 없습니다. 하지만 모델은 다음 토큰을 생성할 때마다 어휘 사전에 존재하는 15만 개 전체 후보의 확률(Softmax)을 매번 계산합니다.
특히 3B~4B 수준의 소형 언어 모델(SLM)에서는 이 어휘 사전 행렬(LM Head)의 크기가 전체 파라미터의 약 10%를 차지합니다. 모델의 10분의 1이 전혀 쓰지 않는 단어들의 확률을 계산하는 데 낭비되고 있는 것입니다.
2. 추론(Inference)의 두 얼굴: 프리필(Prefill) vs 디코드(Decode)
토큰의 개수보다 더 본질적인 문제는 추론이 일어나는 물리적 방식입니다. LLM 추론은 명확히 성격이 다른 2단계로 진행됩니다.
flowchart TD
    subgraph Prefill ["1단계: 프리필 (Prefill) - 입력 처리"]
        P1["수천 개의 입력 토큰을 한 번에 주입"]
        P2["GPU 코어가 병렬 일괄 계산"]
        P3["🔥 연산 바운드 (Compute-bound)<br/>GPU 연산 능력이 한계"]
    end

    subgraph Decode ["2단계: 디코드 (Decode) - 출력 생성"]
        D1["토큰을 한 번에 1개씩 순차 생성"]
        D2["매 토큰마다 모델 전체 가중치를 VRAM에서 다시 로드"]
        D3["🔥 메모리 대역폭 바운드 (Memory-bound)<br/>GPU VRAM 전송 속도가 한계"]
    end

    Prefill -->|KV 캐시 생성 완료| Decode
| 구분 | 프리필 (Prefill / Prompt) | 디코드 (Decode / Generation) |
|---|---|---|
| 작업 대상 | 사용자가 보낸 프롬프트 전체 | 모델이 뱉어내는 응답 텍스트 |
| 처리 방식 | 병렬 일괄 처리 (한 번의 패스) | 자기회귀(Auto-regressive) 순차 처리 (1토큰씩) |
| 병목 지점 | 연산 능력 (Compute-bound) | 메모리 대역폭 (Memory Bandwidth-bound) |
| 가중치 재사용 | 메모리에서 읽은 모델 가중치를 수천 토큰이 공유 | 1개 토큰을 만들 때마다 수십 GB 가중치를 다시 순회 |
| 상대적 비용 | 기준 비용 (1.0x) | 7배 ~ 10배 이상 비쌈 (7.0x+) |
왜 디코드(생성)는 메모리 대역폭에 갇히는가?
프리필 단계에서는 2,000토큰짜리 문서가 들어오면 GPU의 수천 개 CUDA 코어가 2,000개 토큰을 한꺼번에 행렬 곱셈(MatMul)으로 처리합니다. 메모리에서 모델 가중치를 한 번만 읽어와도 수천 개 코어가 연산에 알차게 재사용하므로 GPU 가동률이 100%에 가깝습니다.
하지만 디코드 단계는 다릅니다. 다음 단어는 방금 생성된 단어를 보아야만 결정할 수 있습니다. 병렬 처리가 원천적으로 불가능합니다. 결국 1개 단어를 만들 때마다 4GB~8GB에 달하는 모델 가중치를 VRAM에서 칩으로 싹 긁어와야 합니다. 코어는 연산을 거의 하지 않고 메모리에서 데이터가 도착하기만을 멍하니 기다리게 됩니다.
여기에 이전 대화 맥락을 기억하기 위한 KV 캐시(Key-Value Cache) 메모리 접근까지 가세합니다. 문장이 길어질수록 KV 캐시 크기는 눈덩이처럼 불어나고, GPU는 메모리 병목에 허덕이게 됩니다.
택배 회사 비유:
택배 회사가 들어오는 상자(입력)에는 1,000원을 받으면서, 나가는 상자(출력)에는 7,000원을 받는 셈입니다.
인프라 비용을 줄이고 싶다면 입력 토큰을 줄이는 것보다 출력 토큰을 단 1개라도 줄이는 것이 훨씬 효과적입니다.
3. 어휘를 전문화하면 무슨 일이 일어나는가? (VocabX의 실험)
최근 Dharma AI 연구진이 공개한 VocabX 연구는 이 기본기 원리를 극적으로 증명했습니다.
연구진은 프로덕션 환경에서 포르투갈어 에세이 채점 서비스(Qwen3-4B 기반)를 운영 중이었습니다. 이들은 모델의 가중치를 더 작은 모델로 바꾸지도 않았고, 학습 데이터를 바꾸지도 않았습니다. 오직 어휘 사전(Vocabulary)만 도메인에 맞게 재구성했습니다.
[기존 범용 Qwen3-4B 어휘] (151,669개)
- 전 세계 언어, 마크다운, 코드 등 방대한 미사용 단어 포함
- 출력 JSON 구조가 여러 개 토큰으로 파편화

       ↓↓↓ VocabX 어휘 사전 전문화 (가중치 수정 없음) ↓↓↓

[도메인 특화 어휘]
1. 쓰지 않는 타 언어 토큰 제거 -> LM Head 파라미터 약 10% 감소 (경량화)
2. 자주 반복되는 JSON 스키마·평가 문구를 단일 토큰으로 통합 -> 출력 토큰 수 대폭 감소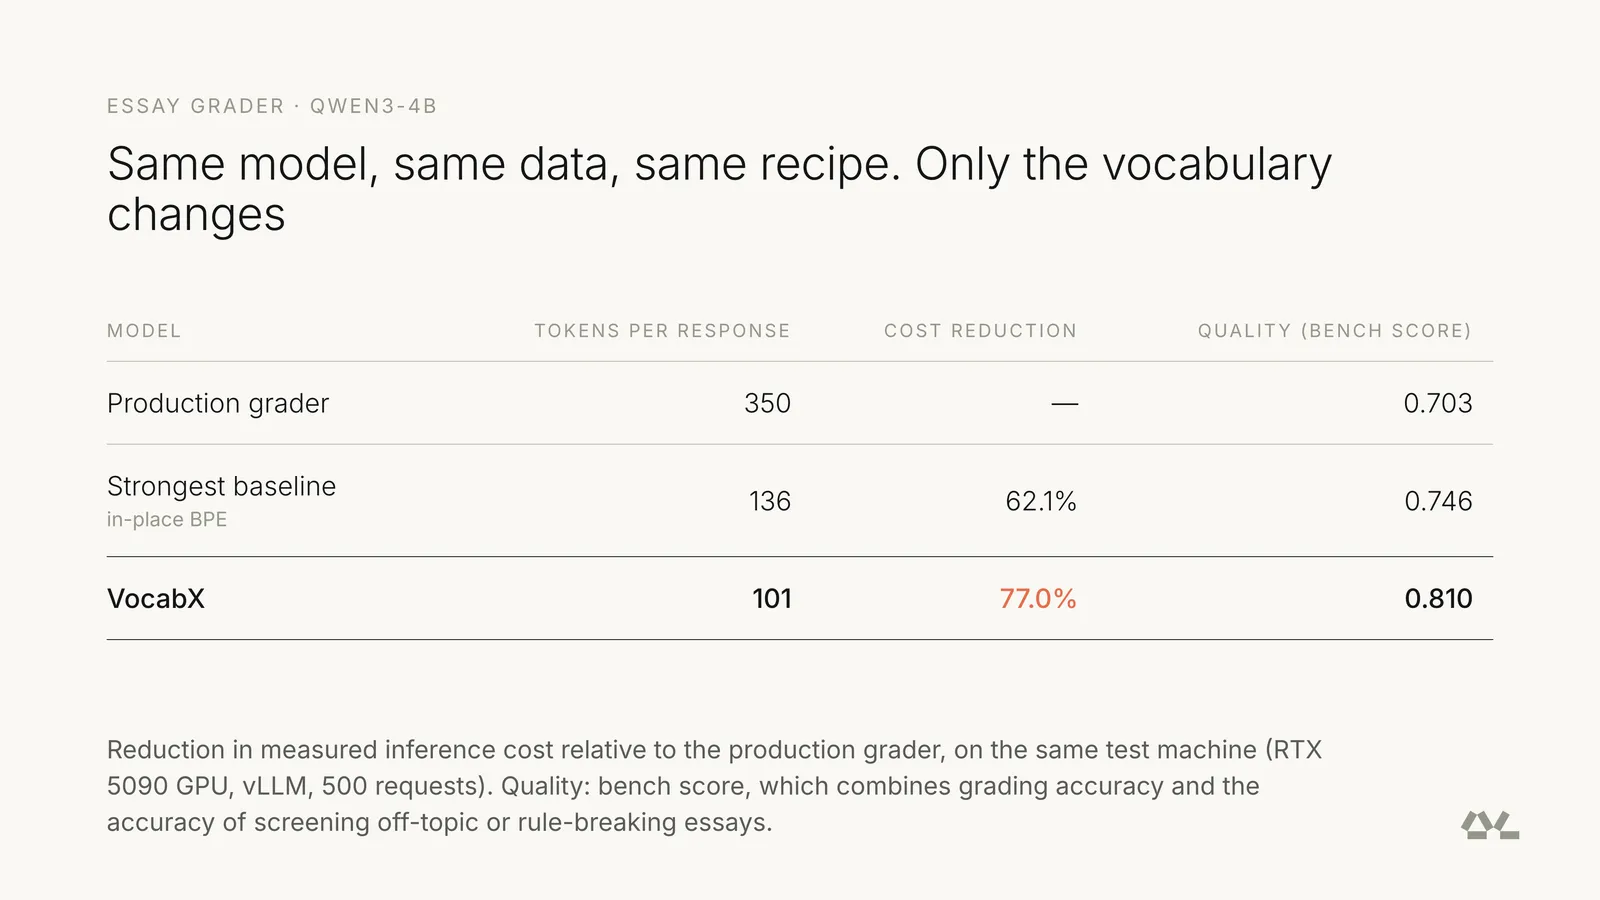
결과는 놀라웠습니다.
- 출력 토큰 수 감소: 반복되는 구조가 1개 토큰으로 합쳐지며 병목이던 디코드 스텝 수 자체가 크게 줄었습니다.
- LM Head 연산량 감소: 매 스텝마다 15만 개 단어의 확률을 구하던 행렬이 압축되었습니다.
- 최종 성과: 동일한 베이스 모델, 동일한 정확도에서 실측 추론 비용을 77% 절감했습니다.
4. 인프라 엔지니어가 얻어야 할 3가지 교훈
이 사례는 AI 시스템을 다루는 인프라 및 백엔드 엔지니어에게 명확한 기준을 제시합니다.
- “토큰 수는 곧 비용”이라는 말은 반쪽짜리 진실입니다.
입력 토큰 1,000개를 아끼는 것보다 출력 토큰 200개를 아끼는 것이 지연 시간(Latency)과 GPU VRAM 관점에서 훨씬 강력합니다. API 프롬프트 엔지니어링을 할 때 “출력 형식을 최대한 간결하고 압축된 형태로 요구해야 하는 이유”가 바로 여기에 있습니다. - 토크나이저는 모델 훈련 전의 고정값이 아니라, 강력한 엔지니어링 레버입니다.
도메인 특화 SLM을 운영한다면, 베이스 모델의 토크나이저를 그대로 상속받아 쓰는 것이 하드웨어 낭비를 초래하고 있지 않은지 점검해야 합니다. - 추론 최적화의 본질은 연산량이 아니라 메모리 대역폭과의 싸움입니다.
프리필은 연산 바운드, 디코드는 메모리 바운드입니다. vLLM의 PagedAttention, 양자화(Quantization), 슬라이딩 윈도우 캐시 등 현대 추론 엔진의 많은 혁신은 결국 디코드 단계에서 메모리 대역폭 병목을 어떻게 우회할 것인가에 집중되어 있습니다.
다음 편 예고
[AI 아키텍처 기본기 2편]
“MoE는 어떻게 500B 거대 모델을 20B처럼 가볍게 돌리는가?”
전체 파라미터(Capacity)와 활성 파라미터(Compute)를 분리하는 라우터 신경망의 원리를 다룹니다.