LLM도 잠을 자야 똑똑해진다: Google의 지속 학습 SLEEP 프레임워크
안녕하세요! 재니미입니다.
배포된 대형 언어 모델(LLM)의 가장 큰 아킬레스건은 지식의 고착(Static Knowledge Cutoff)입니다.
운영 중인 모델에 최신 정보나 새로운 도구 사용법을 가르치려고 계속 미세조정(Fine-tuning)을 진행하면, 기존에 잘하던 코딩이나 추론 능력이 급격히 망가지는 ’파국적 망각(Catastrophic Forgetting)’이 발생합니다. 그렇다고 매번 모든 과거 작업 기록을 프롬프트 컨텍스트에 담아 보내자니, 토큰 비용과 지연 시간이 눈덩이처럼 불어납니다.
2026년 10월 27일, Google Research는 인간 뇌의 수면 메커니즘에서 착안한 지속 학습 아키텍처인 SLEEP 프레임워크를 발표했습니다. 낮에는 실시간 서비스를 제공하고 밤에는 오프라인 유휴 시간에 지식을 파라미터로 압축해 넣는 2단계 생애주기와, MoE 메모리 블록을 활용한 망각 방지 기술을 정리했습니다.
1. 전통적 머신러닝의 한계: 훈련과 추론의 인위적 분리
지금까지의 머신러닝은 “훈련이 끝나면 모델을 고정하고 배포한다”는 단방향 구조였습니다.
하지만 여러 단계에 걸쳐 도구를 사용하고 장시간 작업을 이어가는 자율 에이전트 환경에서 이러한 분리는 한계를 드러냅니다. 운영 환경의 에이전트는 새로운 시스템 API 규약, 사내 지식 베이스의 변경 사항, 그리고 과거의 성공과 실패 경험을 지속해서 흡수해야 하기 때문입니다.
Google 연구진은 훈련과 추론을 영구히 분리하는 대신, 인간이 매일 겪는 수면 주기를 모델의 라이프사이클에 도입했습니다.
2. 활동(Wake)과 수면(Sleep)의 2단계 생애주기
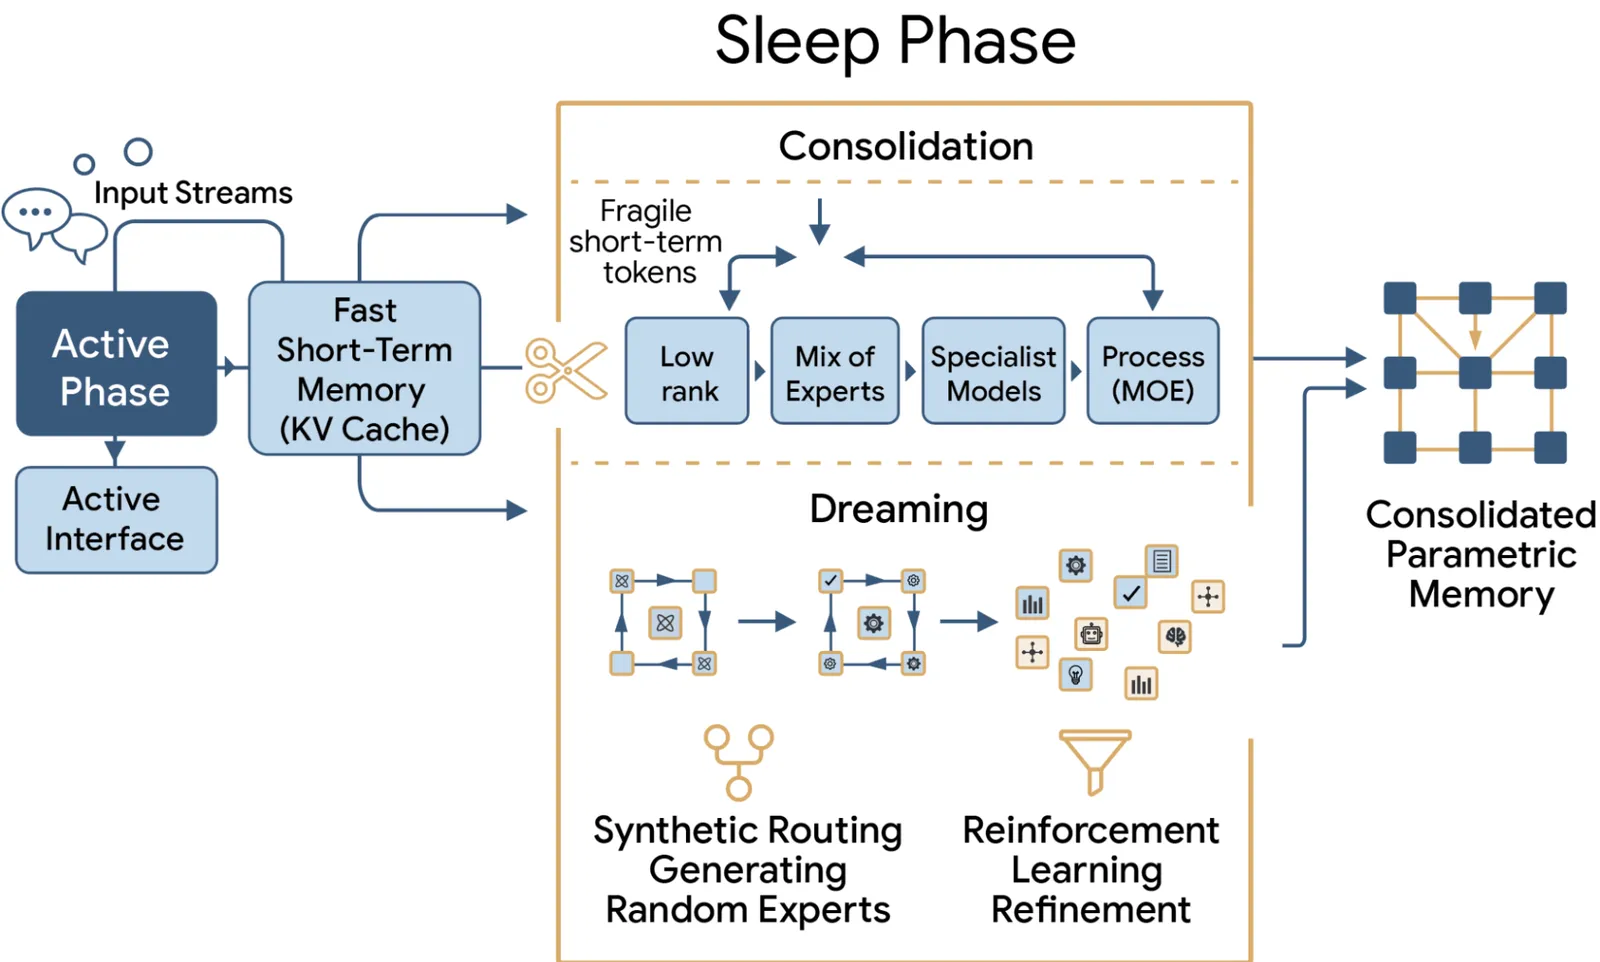
SLEEP 프레임워크에서 모델은 크게 두 가지 상태를 주기적으로 오갑니다.
flowchart TD
    subgraph Wake ["1. 활동 단계 (Wake Phase)"]
        Inference["실시간 추론 서비스"]
        Buffer["단기 컨텍스트 버퍼에 임시 보관<br/>(모델 가중치는 수정하지 않음)"]
        Inference --> Buffer
    end

    subgraph Sleep ["2. 수면 단계 (Sleep Phase)"]
        NREM["NREM 수면 (기억 응고)<br/>사전 할당된 MoE 메모리 블록 활성화<br/>저차원 온폴리시 압축 증류"]
        REM["REM 수면 (꿈꾸기 자기 증류)<br/>전문가 교차 활성화 및 합성 연습 문제 생성<br/>그래디언트 필터링 기반 자기 개선"]
        NREM --> REM
    end

    Buffer --> NREM
    REM -->|"기억 안정화 완료"| Inference
- 활동(Wake) 단계:
실시간 사용자 질의응답을 처리합니다. 이때 모델의 가중치는 절대 수정하지 않으며, 새로 유입된 정보는 고속 단기 컨텍스트 버퍼에만 임시 보관합니다. 서비스 안정성을 유지하면서 지연 시간 없이 응답하는 상태입니다. - 수면(Sleep) 단계:
트래픽이 적은 오프라인 유휴 시간에 가동됩니다. 단기 버퍼에 쌓인 정보들을 두 가지 신경과학적 메커니즘을 거쳐 영구적인 파라미터 기억으로 변환합니다.
3. MoE를 메모리 슬롯으로 쓰는 기억 응고와 꿈꾸기
수면 단계의 핵심은 기존 능력을 훼손하지 않고 새 지식을 새겨 넣는 정교한 2단계 분리입니다.
NREM 수면: 기억 응고 (Memory Consolidation)
인간의 뇌는 깊은 수면(NREM) 동안 낮에 겪은 취약한 단기 기억을 장기 구조로 압축해 저장합니다.
SLEEP 프레임워크는 모델 아키텍처 내부에 미리 할당해 둔 저순위 MoE(Mixture-of-Experts) 전용 메모리 블록을 열어 이를 구현합니다. 낮 동안 버퍼에 쌓인 궤적을 온폴리시 증류(On-policy distillation)와 의미론적 보상 기법으로 압축하여, 정보의 핵심 방향성만 MoE 블록에 기록합니다. 베이스 모델의 핵심 가중치는 건드리지 않기 때문에 기존 지식이 덮어씌워지지 않습니다.
REM 수면: 꿈꾸기 (Dreaming)
새로운 지식을 파라미터에 기록한 뒤, 모델은 렘수면(REM) 상태를 모방한 자율 개선 루프로 들어갑니다.
여러 MoE 전문가 블록을 무작위로 교차 활성화하면서 모델 스스로 합성 연습 문제(꿈)를 만들어냅니다. 그리고 그래디언트 필터링을 통해 의미 있는 학습 신호만 선별하여 온폴리시 자기 증류를 수행합니다. 이 과정을 통해 새로 유입된 지식이 기존 지식과 부드럽게 융합되며 전체적인 추론 능력이 단단해집니다.
4. 벤치마크 결과: 1,000만 토큰 유지력과 망각률 0%
Google 연구진이 공개한 실증 결과는 매우 인상적입니다:
- 희귀 언어 순차 학습:
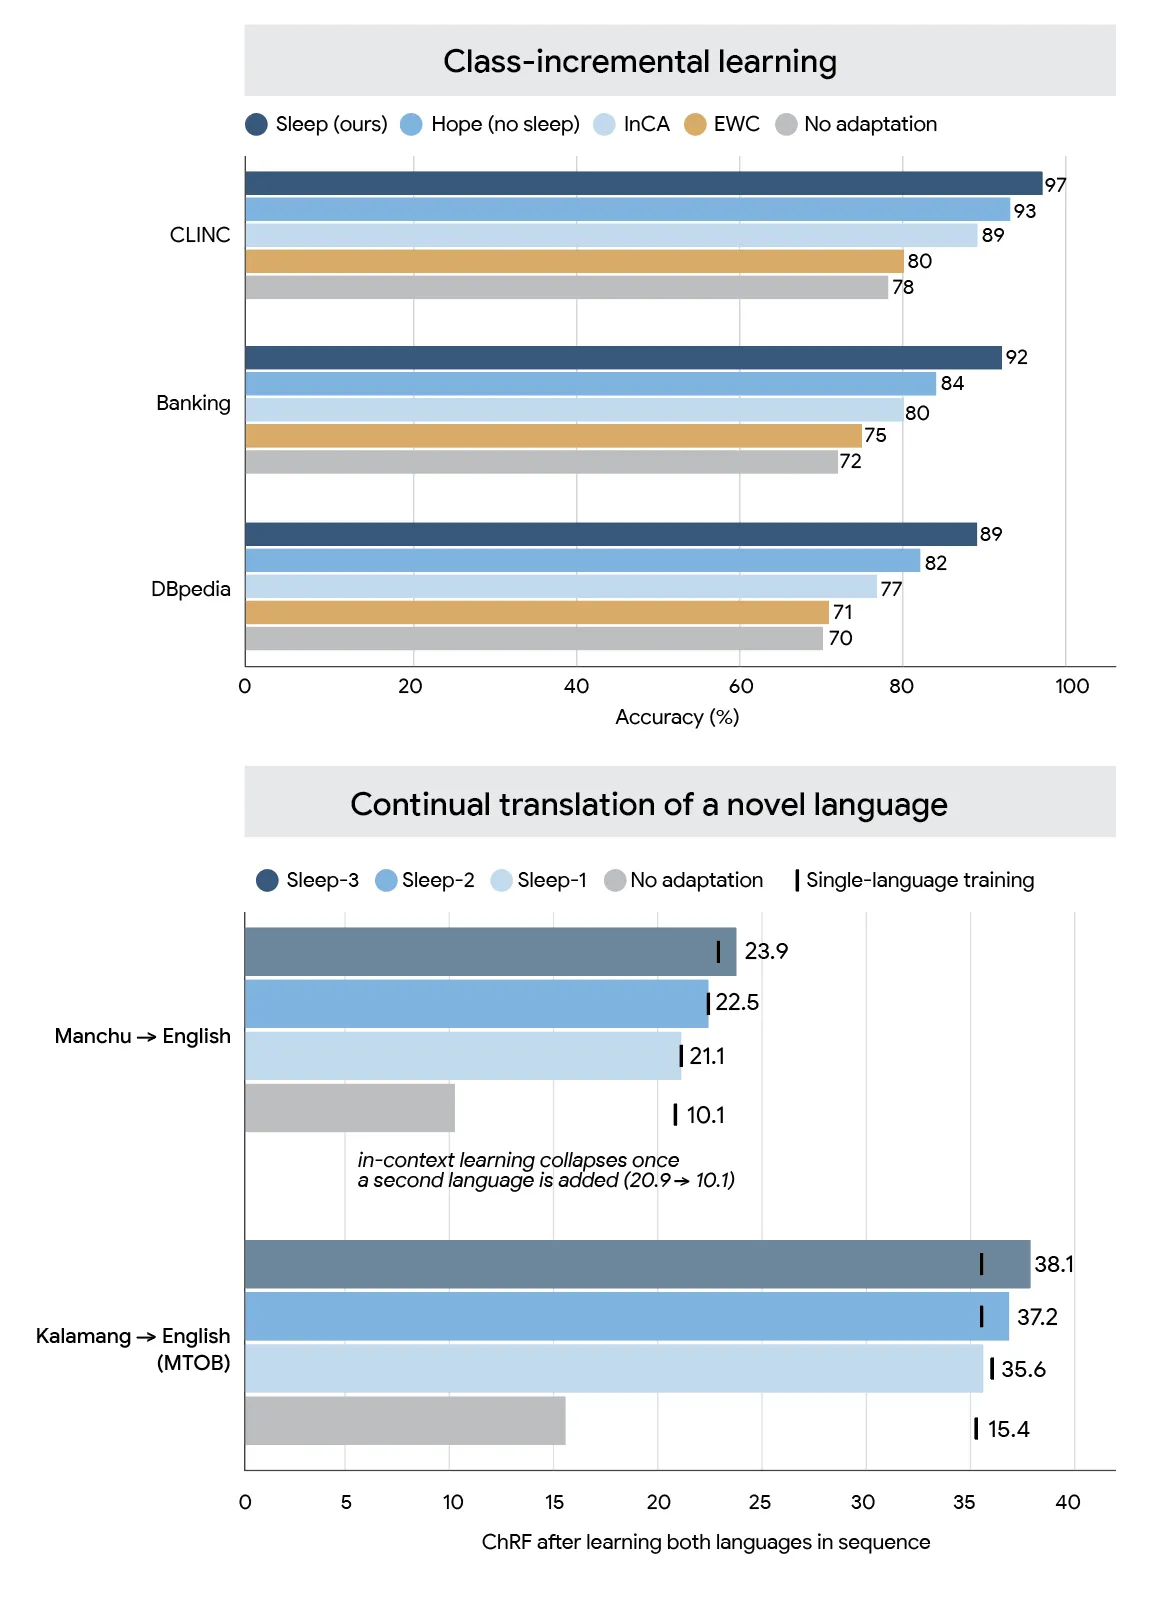
만주어나 칼라망어 같은 미지의 언어를 연속해서 학습시켰을 때, 기존 지도 미세조정(SFT)이나 어댑터 방식은 이전 언어의 지식을 급격히 잃어버렸지만, SLEEP 프레임워크는 성능 저하율 거의 0%를 유지했습니다. - 장기 컨텍스트 소화(BABILong):
수면 단계의 지식 압축 덕분에 최대 1,000만(10M) 토큰에 달하는 방대한 정보를 모델 파라미터 압축 메모리로 소화해 냈습니다. - 복합 수학 추론(AIME / HMMT):
단순 지도학습(SFT)이나 GRPO 강화학습보다 뛰어난 추론 정확도를 기록하며, 기억 응고가 추론 안정성까지 높여준다는 점을 입증했습니다.
💡 엔지니어의 시각: 에이전트 서빙 인프라의 미래
에이전트 시스템을 구축할 때 컨텍스트 윈도우는 고가의 고속 메모리(RAM)이고, 모델 파라미터는 대용량 스토리지(SSD)에 가깝습니다.
그동안 에이전트가 과거의 경험을 기억하게 만드는 방법은 RAM에 모든 과거 대화와 도구 로그를 계속 밀어 넣는 방식뿐이었습니다. 이는 세션이 길어질수록 막대한 토큰 비용과 컨텍스트 오염을 유발합니다.
Google의 SLEEP 프레임워크는 유휴 시간을 활용해 RAM의 단기 기억을 SSD의 예약된 전용 파티션으로 안전하게 스왑(Swap)해 넣는 MLOps 파이프라인의 가능성을 보여줍니다. 앞으로의 AI 인프라는 24시간 고정된 가중치로 응답하는 정적 서버가 아니라, 낮에는 서빙하고 밤에는 스스로 지식을 정리하고 복습하는 ’생애주기형 인프라’로 진화해 갈 것입니다.