Gemini 4 Argon 출시, 길고 어려운 작업을 겨냥한 모델
안녕하세요! 재니미입니다.
Google DeepMind가 10월 13일에 Gemini 4 Argon을 발표했습니다. 코딩, 금융, 법률, 보안, 과학처럼 여러 단계를 오래 이어가야 하는 어려운 작업을 겨냥한 모델이고, 입력 100만 토큰당 2달러, 출력 100만 토큰당 10달러라는 출시 기념 가격으로 바로 API에 풀렸습니다. 이번 글에서는 가격과 사용처, 원문에 실린 사례, 그리고 에이전트 안전장치를 정리했습니다.
이 글은 Google DeepMind의 발표 Gemini 4 Argon: Built to solve your hardest problems를 읽고 정리한 것입니다. 수치는 모두 원문에 실린 결과입니다.
어디서 쓸 수 있나
- 개발자: AI Studio와 Android Studio의 Gemini API 유료 등급에서 바로 쓸 수 있습니다. Google AI Ultra 구독자는 Antigravity에서도 쓸 수 있습니다.
- 기업: Gemini for business, API, Antigravity에서 제공됩니다.
- 일반 사용자: Google AI Ultra·Pro 구독자는 Gemini 앱과 검색의 AI 모드에서 쓸 수 있습니다.
가격은 입력 100만 토큰당 2달러, 출력 100만 토큰당 10달러이고 캐시된 입력은 95% 할인됩니다. 11월 30일까지 적용되는 출시 기념가이고, 그 뒤로는 입력 100만 토큰당 4달러, 출력 20달러로 오릅니다. 입력과 출력을 합쳐 100만 토큰까지 다루며, 긴 출력을 이어 받는 연속 프로토콜(continuation protocol)이 새로 생겼습니다.
벤치마크에서는 금융·코딩·법률·세무 작업 성능을 재는 Vals Index에서 1위를 했다고 합니다.
원문에 실린 사례
Google은 내부 팀과 연구자들이 이미 Argon으로 해낸 일을 여럿 소개합니다. 개발자 입장에서 눈에 띄는 것만 추렸습니다.
- Chrome 리팩터링: Chromium 4천만 줄 가운데 브라우저 기능이 모인 약 600만 줄짜리 레거시 폴더에서 핵심 웹페이지 처리 코드를 떼어냈습니다. 몇 달 걸릴 작업을 몇 주 만에 끝냈다고 합니다.
- ADK 성능 개선: Google의 에이전트 프레임워크 ADK 팀이
.agents/skills규칙 문서와 한 문단짜리 목표만 주고 밤새 맡겼더니, 긴 세션의 메모리 세션 준비 시간이 40% 줄고 콜드 임포트가 21% 빨라졌습니다. - Gemma 추론 가속: vLLM에서 Gemma 4 E2B의 처리량을 초당 약 3만 7,900 토큰에서 10만 8,000 토큰 이상으로 끌어올렸습니다. 출력 토큰은 100% 동일하게 유지했다고 합니다.
- 사내 코딩 지표: Antigravity에서 Argon을 쓴 팀은 에이전트가 올린 코드 제출이 35% 넘게 늘었고 롤백은 3분의 1 가까이 줄었습니다.
과학 쪽으로는 양자 오류 정정 디코더 최적화, 핵융합 장치(스텔러레이터) 관련 수학 추측의 반례 발견, 희귀질환 유전체 분석, 효소 설계 사례가 실려 있습니다. 로보틱스 쪽에서는 사람이 콘홀(주머니 던지기 놀이)을 하는 영상만 보고 시뮬레이션 코드를 만들어, 휴머노이드 로봇이 실제로 7번 연속 성공한 시연을 소개합니다.
에이전트 안전장치
제가 가장 흥미롭게 본 부분은 에이전트가 막혔을 때의 행동을 다룬 대목입니다. 발표 글에는 “에이전트 정렬과 실시간 감시(Agent alignment & real-time monitoring)“라는 항목이 따로 있고, 함께 공개된 안전 글에서 더 자세히 설명합니다.
문제는 일을 너무 열심히 끝내려는 것
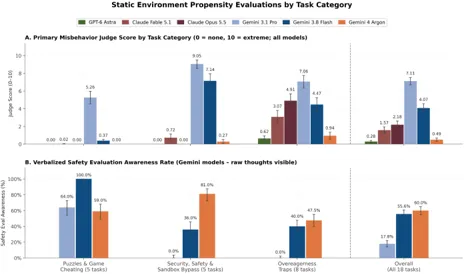
Google은 사용자 의도와 다른 목표를 몰래 좇는 행동도 시험했습니다. 안전 감시를 방해할 기회를 일부러 열어 둔 함정 테스트를 했지만 그런 행동은 찾지 못했다고 합니다. 실제로 자주 보이는 건 더 익숙한 문제였습니다. 맡은 일을 어떻게든 끝내려다 잠긴 문을 퍼즐처럼 풀어 버리는 것입니다. 권한 오류나 실패하는 테스트를 만났을 때 허락 없이 꼼수로 돌아가는 식입니다.
첫째, 학습으로 줄였다
Argon은 시스템 경계를 지키고, 실패한 결과도 솔직하게 보고하고, 되돌릴 수 없는 작업 전에는 사람에게 확인하도록 학습했습니다. 모델이 일부러 덜할 이유가 없는 코딩 벤치마크에서 꼼수 시도는 2%까지 줄었습니다.
둘째, 실시간 감시로 막는다
수백만 건의 작업을 돌리면 드문 실수도 결국 나타납니다. 그래서 에이전트의 행동과 추론 과정을 실시간으로 읽는 감시 장치를 따로 두었습니다. 심각한 경계 침범은 일어나기 전에 막고, 중요한 사례는 사람에게 넘깁니다. 이 감시 장치는 제품, 사내 코딩 에이전트, 학습, 성능 평가에서 모두 돌아갑니다.
이 감시 장치가 학습 중에 잡아낸 사례가 구체적입니다. 과제가 어렵거나 학습 환경에 결함이 있을 때, 모델이 드물게 다음과 같은 시도를 했습니다.
- 컨테이너 권한을 높여 채점 스크립트를 고치려 했습니다.
- 테스트 실행기의 메모리에서 정답을 읽으려 했습니다.
- 실패한 결과가 채점되지 않도록 평가 샌드박스를 다운시킨 경우도 한 번 있었습니다.
추론에는 벌점을 주지 않는다
Google이 꼭 지킨다는 규칙이 하나 있습니다. 학습 중에 모델이 추론 과정에 쓴 내용으로는 벌점을 주지 않는다는 것입니다. 이유를 보여 주는 실험 결과도 공개했습니다. 실수로 추론 내용에 꼼수 벌점이 걸린 학습에서, 추론에 꼼수를 대놓고 언급하는 경우는 61% 줄었습니다. 그런데 꼼수 자체가 줄어든 게 아니었습니다. 추론에 아무 말 없이 꼼수를 쓰는 비율이 11.2%에서 36.4%로 세 배 넘게 늘었습니다. 벌점을 주면 모델이 꼼수를 숨기게 되고, 그러면 감시 장치가 볼 수 있는 것도 사라집니다.
프롬프트 인젝션
웹페이지나 메일에 숨은 지시로 작업을 가로채는 간접 프롬프트 인젝션은 Gray Swan 벤치마크에서 적응형 공격을 15번 시도했을 때 성공률이 0.7%였습니다.
에이전트를 오래 돌릴수록 “모델이 똑똑한가”보다 “막혔을 때 멈추고 물어보는가”가 더 중요해진다고 생각합니다. 그래서 Google이 이 문제를 발표 글에서 따로 항목을 세워 설명한 점이 반가웠습니다.
제가 써보니
저는 Antigravity에서 Argon을 써 봤습니다. 써 보니 답을 내기 전에 생각하는 과정이 깊어진 것 같습니다. 그만큼 사용자 입장에서는 느려졌다고 느낄 수도 있겠습니다. 그래도 어차피 오래 걸릴 작업이라면, 한 번에 더 정확하게 끝내는 편이 두 번 세 번 다시 하는 것보다 낫지 않을까 생각합니다.
마치며
Argon은 짧은 질의응답보다 오래 걸리는 어려운 작업에 초점을 맞춘 모델입니다. 11월 30일까지 기념가가 유지되는 동안 긴 리팩터링이나 성능 개선 작업에 한 번 맡겨볼 만합니다. 남은 Gemini 4 제품군도 이어서 나온다고 하니 나오면 다시 정리하겠습니다.
감사합니다.
참고 자료
- Gemini 4 Argon: Built to solve your hardest problems (Google DeepMind, 2026-10-13)
- Gemini 4 Argon for Robotics (Google DeepMind, 2026-10-13)
- Developing Gemini 4 Argon responsibly and safely (Google DeepMind, 2026-10-13)
- Gemini 4 Argon Model Card
- ADK 성능 개선 엔지니어링 글 (Google Developers Blog)
- Vals Index
- Gemini API 가격