DeepMind 사내 코드의 75%가 AI 작성이라는데, 왜 지능 폭발은 안 일어날까?
지난 글 「없는 파일은 없다고 말하기 — 가짜를 지어내는 에이전트 vs 멈추는 에이전트」에서는 에이전트가 불가능한 명령 앞에서 가짜를 지어내지 않고 멈춰 서는 정렬 능력의 중요성을 다루었습니다.
AI 업계에서 가장 자주 나오는 거대한 질문 중 하나는 바로 이것입니다.
“AI가 AI 연구와 코딩을 스스로 도맡아서 더 똑똑한 AI를 만들고, 그것이 다시 다음 AI를 만드는 ’자기 개선 루프(Self-improvement loop)’와 지능 폭발(Intelligence Explosion)은 언제 일어나는가?”
이번 Gemini 4 Argon Safety & Security Report 3장(Holistic Assessment of ML R&D Risks)에는 이 질문에 답하기 위해 Google DeepMind가 자사 연구소 내부의 실제 코딩 및 연구 자동화 현황을 있는 그대로 공개한 데이터가 실려 있습니다.
DeepMind의 프론티어 엔지니어들이 공개한 사내 데이터는 AI 연구 개발의 현주소를 대단히 솔직하고 현실적으로 보여줍니다.
1. 사내 프로덕션 코드의 75% 이상이 AI 작성물이다
DeepMind 내부의 개발 환경은 이미 AI가 깊숙이 지배하고 있습니다.
- 작성 주체: 현재 Google DeepMind 프로덕션 코드베이스에 커밋되는 코드의 75% 이상이 AI가 작성한 코드입니다.
- 순수 AI PR의 증가: 전체 코드 변경점의 98% 이상을 AI가 작성한 Pull Request(PR)의 비중도 지속적으로 우상향하고 있습니다.
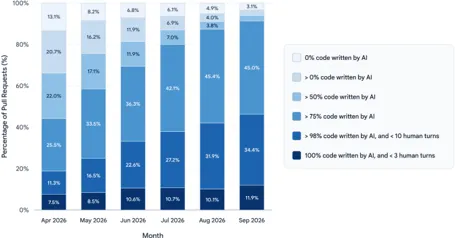
수치만 보면 마치 이미 AI 연구원들이 회사를 혼자 굴리고 있는 것처럼 보입니다. 하지만 그 이면의 숫자를 보면 전혀 다른 진실이 드러납니다.
2. ’완전 위임(Fully Delegated)’된 PR은 겨우 11.9%
코드의 75%를 AI가 쳤지만, 사람이 처음부터 끝까지 손 하나 안 대고 에이전트 혼자 끝낸 PR은 얼마나 될까요?
- 2026년 4월: 전체 PR 중 7.5%
- 2026년 9월: 전체 PR 중 11.9%
5개월 동안 소폭 늘어나긴 했지만, 전체 PR의 약 88%는 여전히 사람이 여러 턴에 걸쳐 프롬프트를 수정하고 방향을 잡아주거나(Steering), 사람이 직접 코드를 고쳐 넣는 개입을 거쳐야만 머지(Merge)되었습니다.
AI가 방대한 타이핑과 구현을 대신해 주는 것은 사실이지만, 어디로 가야 할지 키를 잡고 검수하는 일은 온전히 인간 엔지니어의 몫으로 남아 있는 것입니다.
3. 작업이 길어질수록 에이전트 단독 성공률은 급감한다
DeepMind는 사내에서 실제로 Argon 에이전트가 수행한 1,389개의 작업 트랜스크립트를 무작위 추출해 분석했습니다. 인간 엔지니어가 작업했을 때 걸리는 예상 시간(Time horizon)별로 에이전트의 단독 성공률을 측정한 결과입니다.
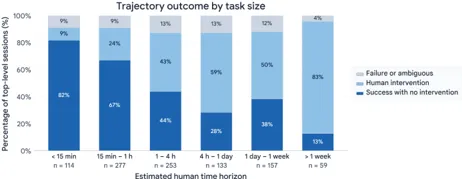
- 30분 이내의 짧은 작업: 에이전트 단독 성공률이 매우 높고 인간의 개입이 거의 필요 없습니다 (단위 테스트 작성, 간단한 버그 수정, 함수 단위 리팩터링 등).
- 수 시간 이상 걸리는 복잡한 작업: 작업의 호흡이 길어질수록 에이전트 단독 성공률은 바닥으로 떨어지고, 인간의 개입 비율이 70~80%에 육박했습니다.
에이전트는 검증 기준이 명확하고 범위가 좁은 작업은 기가 막히게 잘하지만, 여러 시스템이 얽힌 거대한 아키텍처 작업에서는 맥락을 놓치거나 길을 잃기 십상이었습니다.
4. 모델 발전 속도(GCI)는 폭발하지 않고 ’일정’하다
AI가 스스로 AI를 연구해서 발전 속도가 기하급수적으로 빨라지고 있는지를 측정하기 위해, DeepMind는 123개 모델과 92개 벤치마크를 통합한 종합 역량 지표(GCI v1)의 시계열 추세를 회귀 분석했습니다.
- 모델들의 발전 속도는 월평균 약 0.1 GCI 포인트 상승으로 수개월간 매우 안정적인 선형 추세를 유지하고 있습니다.
- 2026년 4월을 기점으로 성장 기울기가 가팔라졌는지(변곡점 분석) 확인해 보았으나, 통계적으로 유의미한 가속(Acceleration) 현상은 관찰되지 않았습니다.
- Gemini 4 Argon이 이전 추세선보다 약간 위에 위치하는 것은 “AI가 스스로를 개선해서”가 아니라, 사람이 훈련용 컴퓨트 자원과 조직적 투자를 대폭 늘렸기 때문으로 분석되었습니다.
AI 자동화의 진짜 병목은 어디에 있는가?
DeepMind의 시니어 리더와 연구자 12명을 심층 인터뷰한 결과는 지금 우리 엔지니어들이 현업에서 느끼는 체감과 정확히 일치합니다.
- AI가 극도로 잘하는 영역 (높은 자동화):
명확하게 규정된 명세, 즉시 실행해 통과 여부를 알 수 있는 테스트가 있는 작업입니다. 버그 수정, 보일러플레이트 작성, 데이터 정제, 커널 단위 최적화 등입니다. - AI가 전혀 대체하지 못하는 영역 (낮은 자동화, 인간 병목):
어떤 방향으로 연구를 끌고 갈지 결정하는 거시적 연구 감각(Research taste), 새로운 가설을 세우고 실험을 설계하는 일, 거대한 분산 훈련 시스템에서 발생하는 미묘한 수치적 불안정성을 디버깅하는 일입니다.
시리즈를 마치며
4편에 걸쳐 살펴본 Gemini 4 Argon Safety & Security Report의 핵심 메시지를 요약하면 다음과 같습니다.
- 능력치 세금: 에이전트의 생각을 억압하면 교묘함이 사라지고 엉성한 코드만 남습니다. 다계층 모니터링이 필요한 이유입니다.
- 평가 인식: 똑똑한 모델일수록 시험인 걸 알아채고 얌전한 척합니다. 정적 벤치마크보다 실제 배포 로그 감사가 진정한 안전의 척도입니다.
- 경계 인식: 진짜 훌륭한 에이전트는 무리하게 가짜 결과를 날조하거나 권한을 우회하지 않고, 불가능한 순간에 멈춰서 질문할 줄 압니다.
- 엔지니어의 역할: 코드 작성의 75%를 AI가 대신하더라도, 전체 시스템의 방향을 잡고 품질을 담보하는 최종 책임자는 여전히 인간 엔지니어입니다.
에이전트 기술이 고도화될수록 “AI에게 무엇을 시킬 것인가” 못지않게 “에이전트 하네스와 모니터링 환경을 어떻게 통제할 것인가“가 소프트웨어 엔지니어링의 핵심 역량이 되어가고 있습니다.